🍄 Este tutorial muestra cómo usar MicroBioMeta con
datos de metagenómica shotgun, como alternativa al
flujo de trabajo de amplicón (metabarcoding) cubierto en la viñeta de Amplicón. Las funciones y la
mayoría de sus parámetros son exactamente los mismos en ambos flujos de
trabajo, así que no se vuelven a explicar aquí; solo se explica lo que
es específico de los datos metagenómicos. Las instrucciones de
instalación están en la viñeta de
Amplicón.
Para este ejemplo, las lecturas fueron clasificadas taxonómicamente
con Kraken2
(Wood et al.
2019) y corregidas en abundancia a nivel de especie con Bracken
(Lu et al.
2017).
Los datos provienen de suelos forestales a lo largo de los transectos Iztaccíhuatl-Popocatépetl (PNIP) y La Malinche (PNML), en el centro de México:
Datos crudos, metadatos y los scripts originales del análisis: github.com/Steph0522/Fungal_Metagenomes_PNIP_PNML
Cargar los datos
Primero, carguemos MicroBioMeta y tidyverse
(usado para el manejo de datos):
Cada muestra se procesó por separado, así que los reportes
bracken_species se combinaron de antemano en una sola tabla
(una columna por muestra, llamada
kraken_pluspfp_<id_metagenome>_report_bracken_species)
con una columna taxonomy ya agregada como
última columna:
table_kraken <- read.delim(
    system.file("extdata", "table_kraken.txt", package = "MicroBioMeta"),
    row.names = 1, check.names = FALSE
)

table_kraken[1:3, c(1:2, ncol(table_kraken))]
## kraken_pluspfp_100_report_bracken_species
## 101028 1302
## 36050 161
## 56646 108
## kraken_pluspfp_105_report_bracken_species
## 101028 1066
## 36050 345
## 56646 203
## taxonomy
## 101028 k__Eukaryota; p__Ascomycota; c__Sordariomycetes; o__Hypocreales; f__Nectriaceae; g__Fusarium; s__pseudograminearum
## 36050 k__Eukaryota; p__Ascomycota; c__Sordariomycetes; o__Hypocreales; f__Nectriaceae; g__Fusarium; s__poae
## 56646 k__Eukaryota; p__Ascomycota; c__Sordariomycetes; o__Hypocreales; f__Nectriaceae; g__Fusarium; s__venenatumLa taxonomía ya está en la tabla, así que no hace falta usar la
función merge_feature_taxonomy().
⚠️ Las cadenas de taxonomía de Kraken2 usan un prefijo
k__/p__/c__/… como SILVA, pero
los rangos están separados por "; " (punto y coma y
espacio) en vez de ";". MicroBioMeta
ya tiene esto contemplado en cualquier lugar donde exista un argumento
taxonomy_db, solo pasa
taxonomy_db = "Kraken2".
Ahora, carguemos los metadatos:
metadata_meta <- read.delim(
    system.file("extdata", "metadata_metagenomic.txt", package = "MicroBioMeta"),
    check.names = FALSE
)

head(metadata_meta[, 1:10])
## SAMPLEID id_sequence id_metagenome Poligono Sitio Transecto id_new id_fisicoq
## 1 P1S1T1 111 140 1 1 1 30 30
## 2 P1S1T2 112 152 1 1 2 13 <NA>
## 3 P1S1T3 113 164 1 1 3 21 21
## 4 P1S2T1 121 176 1 2 1 11 11
## 5 P1S2T2 122 188 1 2 2 33 13,33
## 6 P1S2T3 123 121 1 2 3 12 12
## Sites Names
## 1 1 Tetlanohcan 1
## 2 1 Tetlanohcan 1
## 3 1 Tetlanohcan 1
## 4 2 Tetlanohcan 2
## 5 2 Tetlanohcan 2
## 6 2 Tetlanohcan 2Los nombres de columna de Kraken codifican un número
id_metagenome (por ejemplo,
kraken_pluspfp_100_report_bracken_species) en vez del ID
real de la muestra, así que lo recuperamos con una expresión regular y
usamos metadata_meta$id_metagenome para renombrar cada
columna a su SampleID:
sample_cols <- setdiff(colnames(table_kraken), "taxonomy")

id_metagenome <- as.integer(gsub("kraken_pluspfp_|_report_bracken_species", "", sample_cols))

colnames(table_kraken)[match(sample_cols, colnames(table_kraken))] <-
    metadata_meta$SAMPLEID[match(id_metagenome, metadata_meta$id_metagenome)]
Renombremos y demos formato a los metadatos:
metadata_meta$Polygon <- factor(paste0("Pol", metadata_meta$Poligono), levels = paste0("Pol", 1:6))
metadata_meta$Site <- as.character(metadata_meta$Sitio)
table_meta <- table_kraken[, c(metadata_meta$SAMPLEID, "taxonomy")]Las coordenadas se tomaron y cargaron así:
coord_meta <- read.csv(
    system.file("extdata", "coord_metagenomic.csv", package = "MicroBioMeta")
) %>%
    dplyr::select(-Site) %>% # descartamos el índice de sitio general propio del CSV (1-12); queremos `Sitio` (1-2) en su lugar
    dplyr::rename(Polygon_num = pol, Site = Sitio) %>%
    dplyr::select(Polygon_num, Site, Transecto, Latitude, Longitude)

metadata_meta <- metadata_meta %>%
    dplyr::mutate(Polygon_num = as.integer(gsub("Pol", "", Polygon)), Site = as.integer(Site)) %>%
    dplyr::left_join(coord_meta, by = c("Polygon_num", "Site", "Transecto")) %>%
    dplyr::mutate(Site = as.character(Site))
Empezar desde un objeto phyloseq o TreeSummarizedExperiment
MicroBioMeta trabaja con tablas simples, pero si tus
datos ya están en un objeto phyloseq o en un
TreeSummarizedExperiment (el contenedor de Bioconductor que
usa la familia de paquetes mia),
from_phyloseq() y from_tse() los convierten en
la table (con la columna taxonomy al final) y
la metadata (con SAMPLEID primero) que usamos
en esta viñeta.
Para mostrarlo, guardamos la tabla de Kraken2 en un
TreeSummarizedExperiment, con una columna de taxonomía por
rango, como lo haría mia:
counts <- as.matrix(table_meta[, metadata_meta$SAMPLEID])

ranks <- tidyr::separate(
    data.frame(taxonomy = gsub("[kpcofgs]__", "", table_meta$taxonomy)),
    taxonomy, c("Kingdom", "Phylum", "Class", "Order", "Family", "Genus", "Species"),
    sep = "; ", fill = "right"
)
rownames(ranks) <- rownames(table_meta)

samples <- metadata_meta
rownames(samples) <- samples$SAMPLEID

tse <- TreeSummarizedExperiment::TreeSummarizedExperiment(
    assays  = list(counts = counts),
    rowData = ranks,
    colData = samples
)
tse
## class: TreeSummarizedExperiment
## dim: 87 36
## metadata(0):
## assays(1): counts
## rownames(87): 101028 36050 ... 208348 27350
## rowData names(7): Kingdom Phylum ... Genus Species
## colnames(36): P1S1T1 P1S1T2 ... P6S2T2 P6S2T3
## colData names(34): SAMPLEID id_sequence ... Latitude Longitude
## reducedDimNames(0):
## mainExpName: NULL
## altExpNames(0):
## rowLinks: NULL
## rowTree: NULL
## colLinks: NULL
## colTree: NULLfrom_tse() regresa una lista con los dos data
frames:
##        P1S1T1 P1S1T2
## 101028   1985   4341
## 36050     236    231
## 56646     175    151
##                                                                                                                  taxonomy
## 101028 k__Eukaryota; p__Ascomycota; c__Sordariomycetes; o__Hypocreales; f__Nectriaceae; g__Fusarium; s__pseudograminearum
## 36050               k__Eukaryota; p__Ascomycota; c__Sordariomycetes; o__Hypocreales; f__Nectriaceae; g__Fusarium; s__poae
## 56646          k__Eukaryota; p__Ascomycota; c__Sordariomycetes; o__Hypocreales; f__Nectriaceae; g__Fusarium; s__venenatum
mbm$metadata[1:3, 1:5]## SAMPLEID id_sequence id_metagenome Poligono Sitio
## 1 P1S1T1 111 140 1 1
## 2 P1S1T2 112 152 1 1
## 3 P1S1T3 113 164 1 1y se pueden usar directo en cualquier función, por ejemplo
abundance_bar_plot(table = mbm$table, metadata = mbm$metadata, ...).
Con un objeto phyloseq funciona igual:
mbm <- from_phyloseq(physeq)Exploración de la composición
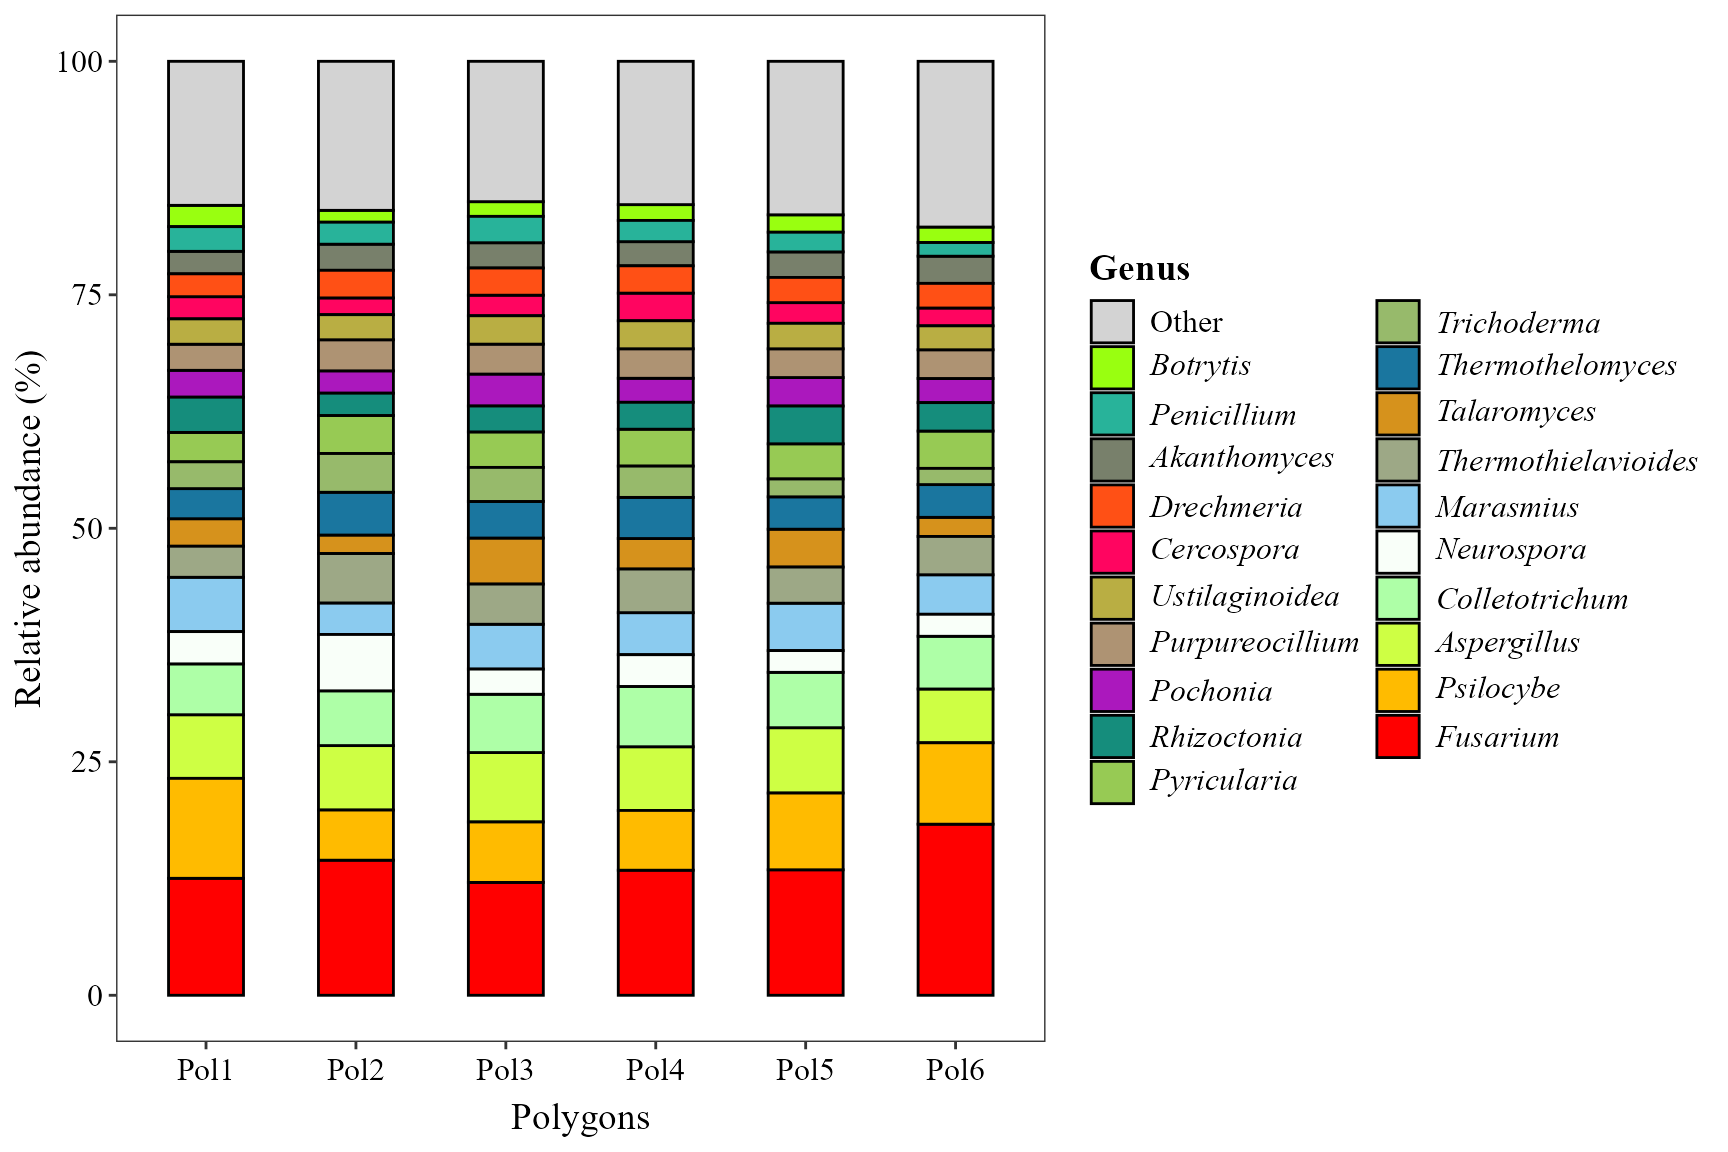
Barplot de abundancia
Misma función que en la viñeta de amplicón; la única diferencia es
taxonomy_db = "Kraken2", que le indica a la lógica de
parseo de taxonomía que espere cadenas estilo Kraken2/Bracken.
abundance_bar_plot(
    table = table_meta,
    metadata = metadata_meta,
    taxonomy_db = "Kraken2",
    level = "genus",
    top_n = 20,
    x_col = "Polygon",
    x_axis_title = "Polygons",
    add_remained = TRUE,
    label = "Genus",
    save_table = FALSE
)
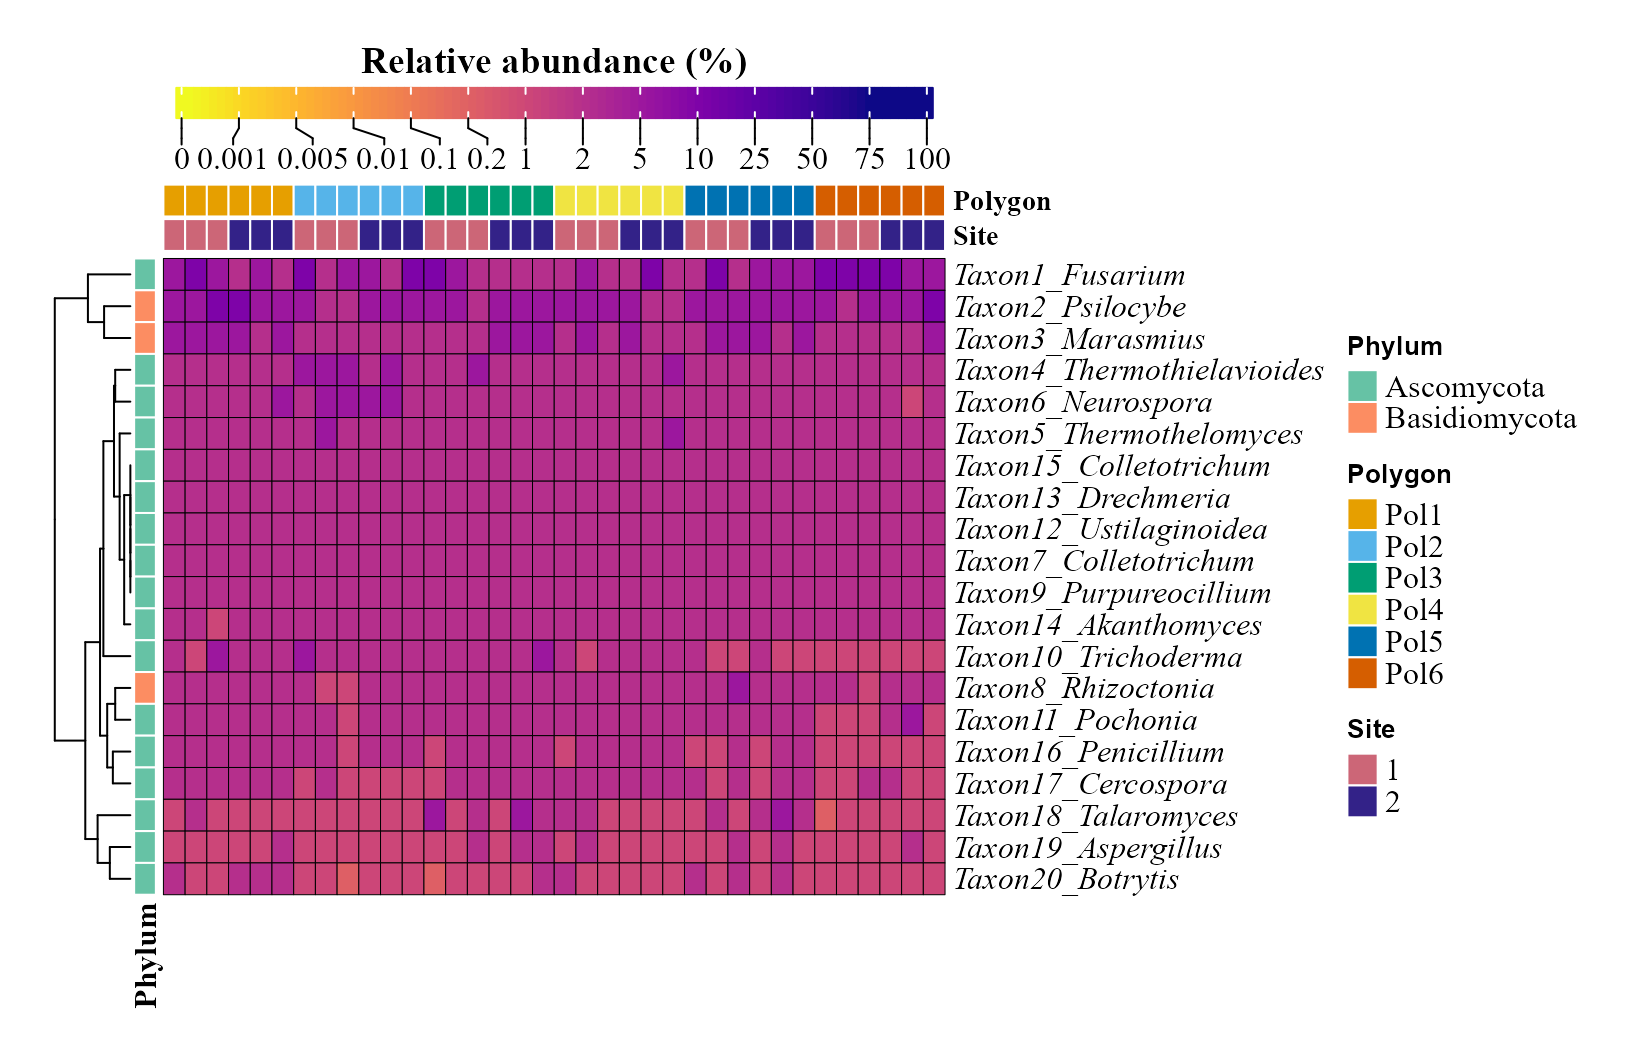
Heatmap de abundancia
Los taxones de Kraken2/Bracken no son ASVs, así que aquí se usa
feature_prefix = "Taxon" en vez del prefijo
"ASV" por defecto para las etiquetas de fila.
condition2 agrega una segunda barra de anotación, aquí el
sitio de muestreo dentro de cada polígono.
abundance_heatmap_plot(
    table = table_meta,
    metadata = metadata_meta,
    top_n = 20,
    show_column_names = FALSE,
    condition1 = "Polygon",
    condition2 = "Site",
    feature_prefix = "Taxon"
)
Diversidad alfa
Como en la viñeta de metabarcoding, primero se puede usar
alpha_hill_corr_plot(table = table_meta) para revisar si
los números de Hill dependen de la profundidad de secuenciación.
Visualización de diversidad alfa
fill_col es igual a x_col aquí, así que la
leyenda solo repetiría las etiquetas del eje x -
show_legend = FALSE la quita.
alpha_hill_plot(
    table = table_meta,
    metadata = metadata_meta,
    x_col = "Polygon",
    fill_col = "Polygon",
    facet_by = "Site",
    facet_orientation = "horizontal",
    legend_title = "",
    stat = "kruskal.test",
    show_legend = FALSE,
    save_table = FALSE
)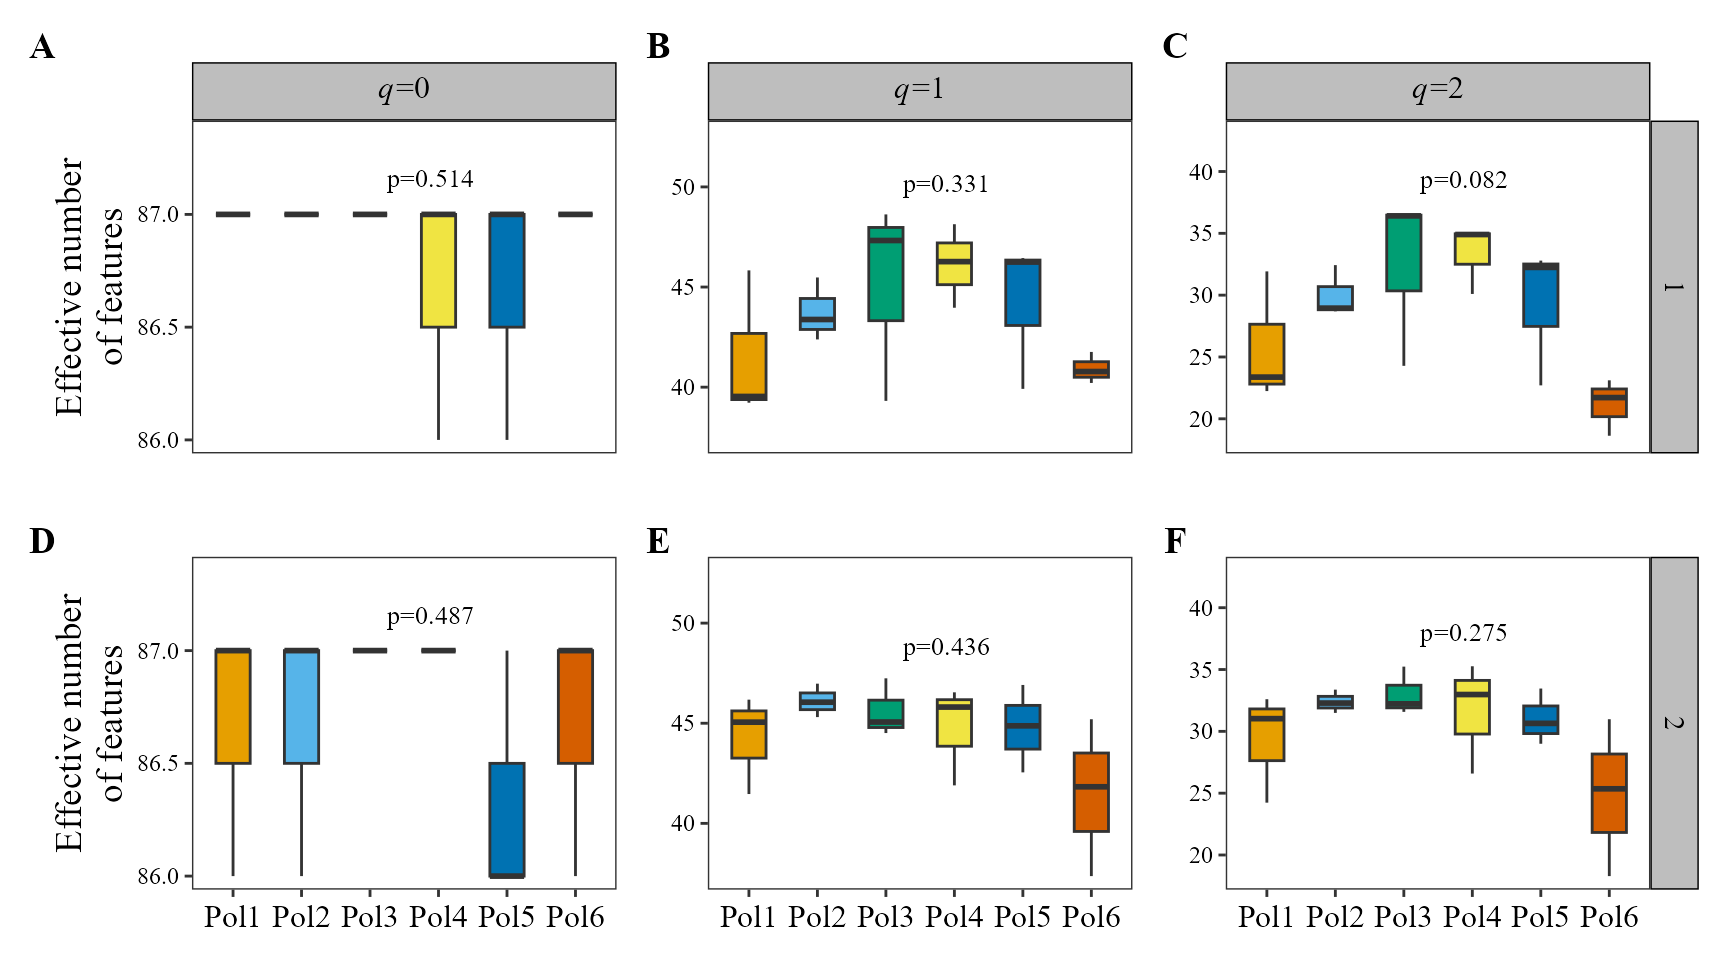
La riqueza (q=0) está casi saturada y plana entre polígonos aquí — esta tabla de Bracken a nivel de especie tiene solo 87 especies de hongos, 83 de ellas presentes en las 36 muestras, así que hay poco margen para variar en q=0 — mientras que q=1 y q=2 (que ponderan por abundancia relativa) sí capturan diferencias entre polígonos.
Diversidad alfa a lo largo de un gradiente continuo
alpha_decay_plot(
    table = table_meta,
    metadata = metadata_meta,
    cont_var = "pH",
    x_axis_title = "Soil pH"
)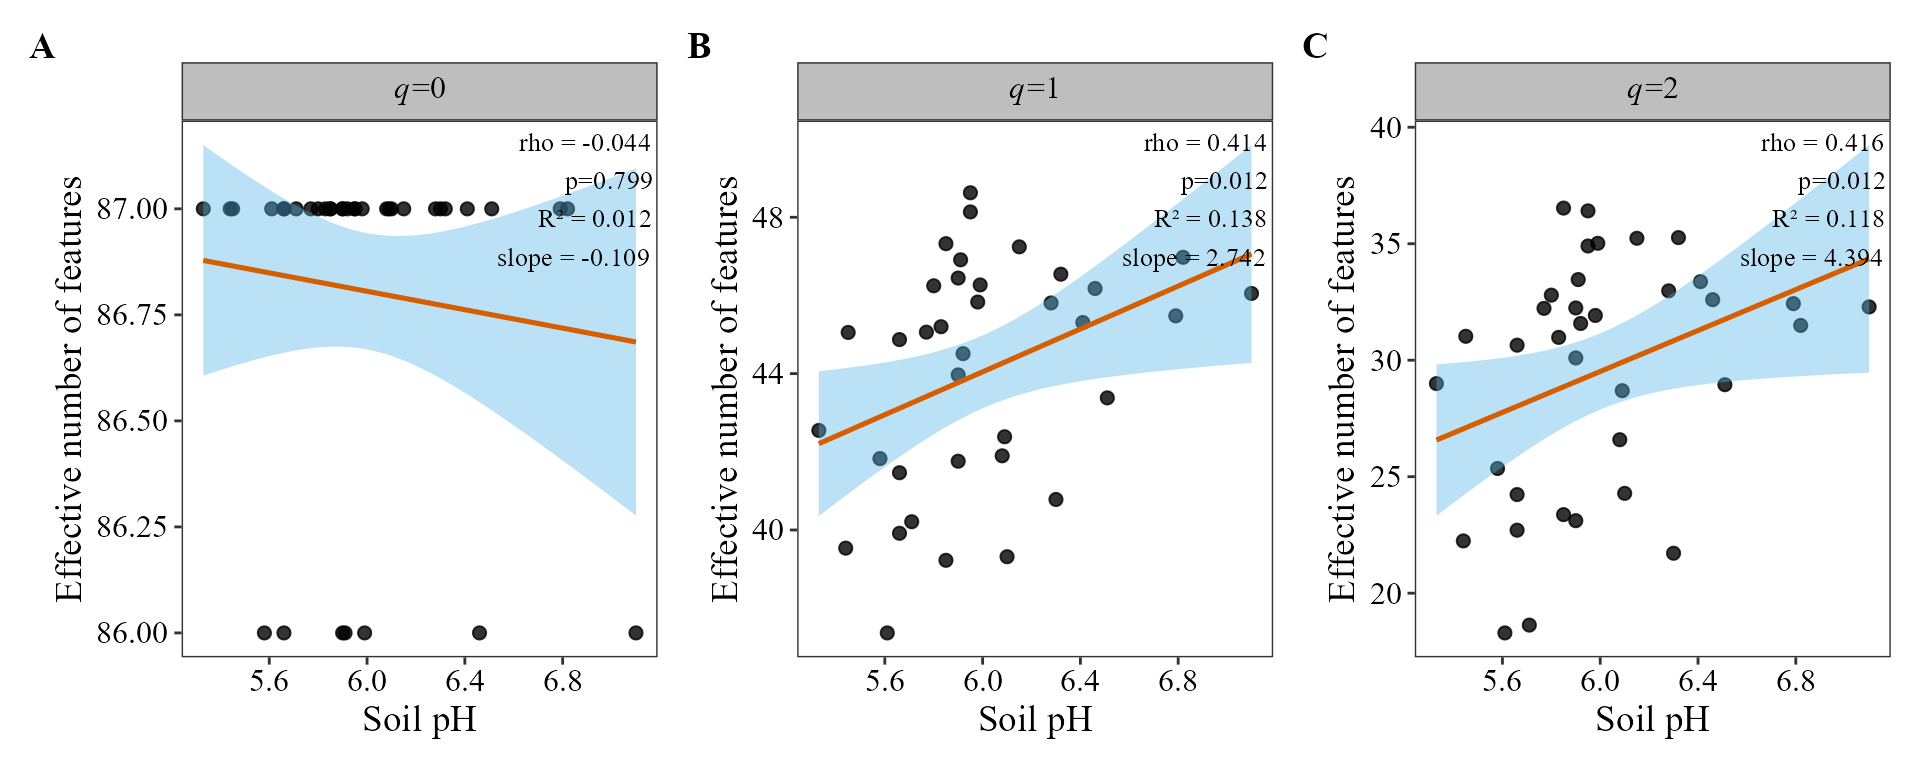
La diversidad en q=1 y q=2 aumenta significativamente con el pH del suelo; q=0 no, por la misma razón de efecto techo que arriba.
Diversidad beta
Ordenación de la composición de la comunidad
Aquí usamos la disimilitud de Bray-Curtis, que toma
en cuenta la abundancia de cada taxón, con una ordenación
NMDS. NMDS parte de configuraciones al azar, así que
usamos set.seed() para obtener siempre la misma figura:
set.seed(123)
beta_ord_plot(
    table = table_meta,
    metadata = metadata_meta,
    distance = "bray",
    ordination = "NMDS",
    group_col = "Polygon"
)
## Run 0 stress 0.109415
## Run 1 stress 0.1100308
## Run 2 stress 0.1436787
## Run 3 stress 0.109415
## ... New best solution
## ... Procrustes: rmse 4.898679e-05 max resid 0.0002427814
## ... Similar to previous best
## Run 4 stress 0.1282595
## Run 5 stress 0.109415
## ... Procrustes: rmse 5.347491e-05 max resid 0.0002695176
## ... Similar to previous best
## Run 6 stress 0.1100308
## Run 7 stress 0.1360412
## Run 8 stress 0.1426357
## Run 9 stress 0.1100309
## Run 10 stress 0.1360412
## Run 11 stress 0.1095935
## ... Procrustes: rmse 0.01783814 max resid 0.09869714
## Run 12 stress 0.1095934
## ... Procrustes: rmse 0.01783822 max resid 0.09870617
## Run 13 stress 0.1282595
## Run 14 stress 0.109415
## ... Procrustes: rmse 2.319858e-05 max resid 0.0001086243
## ... Similar to previous best
## Run 15 stress 0.1360412
## Run 16 stress 0.109415
## ... New best solution
## ... Procrustes: rmse 1.046168e-05 max resid 5.28883e-05
## ... Similar to previous best
## Run 17 stress 0.109415
## ... Procrustes: rmse 2.890036e-05 max resid 0.0001565367
## ... Similar to previous best
## Run 18 stress 0.109415
## ... Procrustes: rmse 1.762475e-05 max resid 8.27359e-05
## ... Similar to previous best
## Run 19 stress 0.1095934
## ... Procrustes: rmse 0.01783515 max resid 0.09870479
## Run 20 stress 0.1100308
## *** Best solution repeated 3 times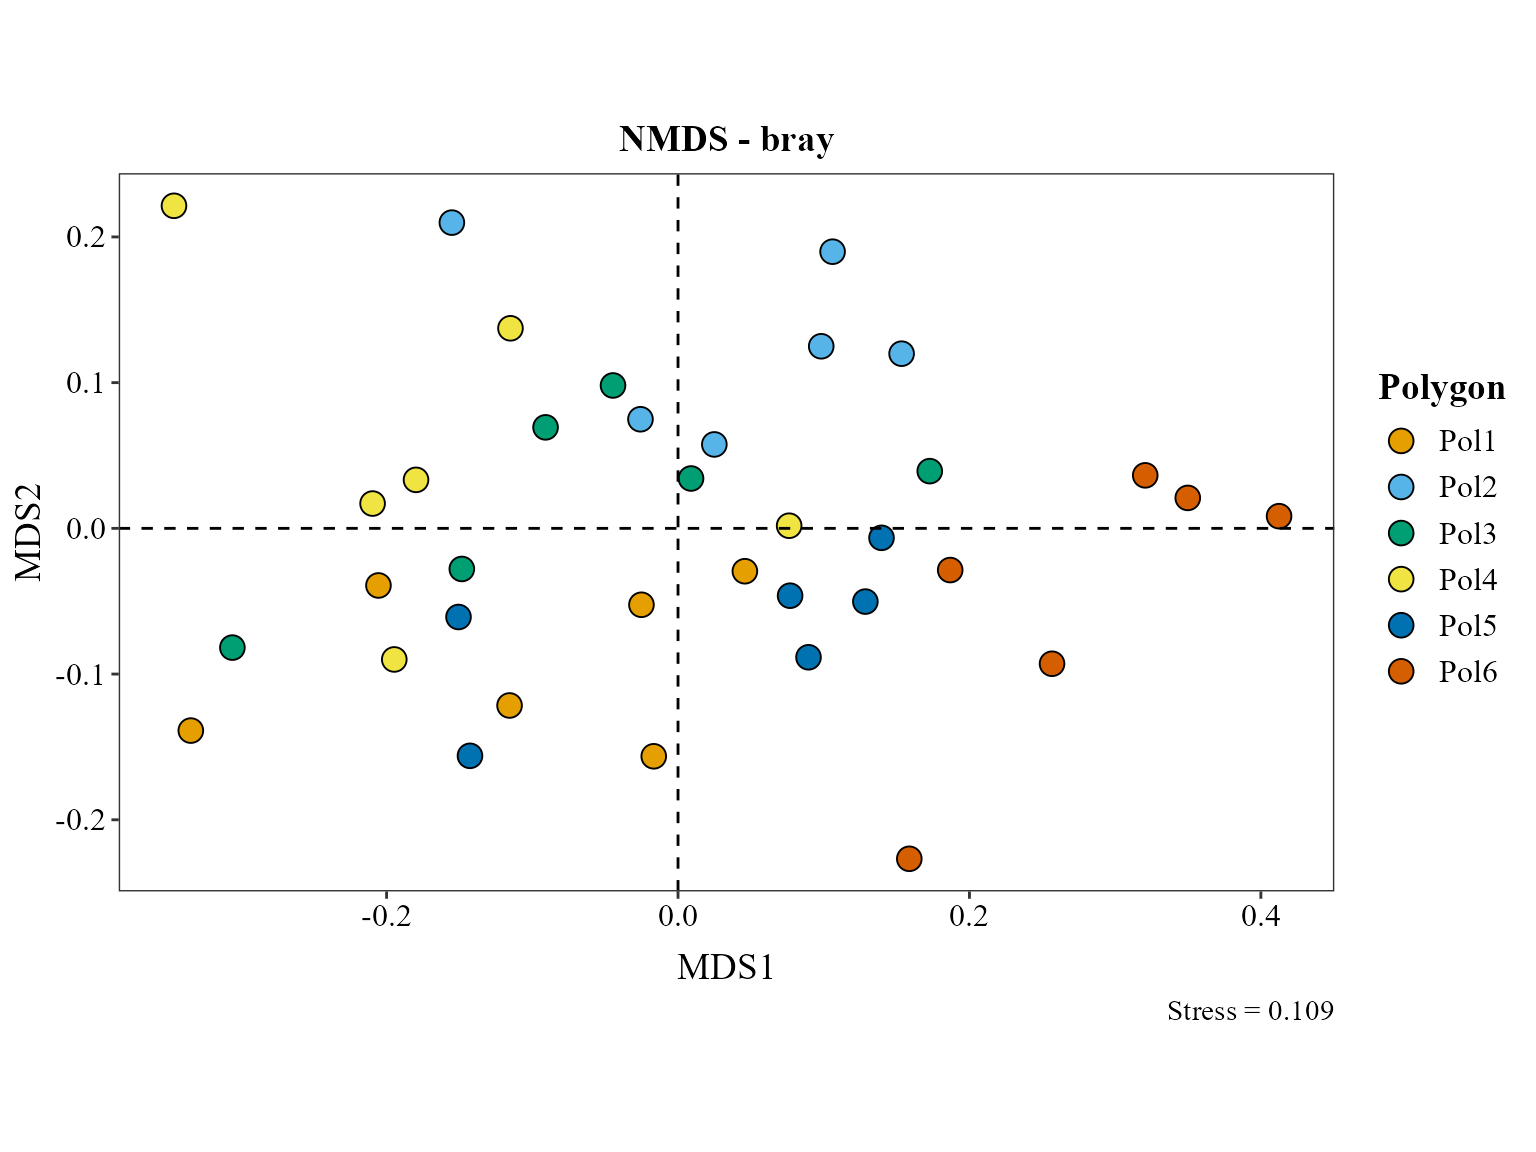
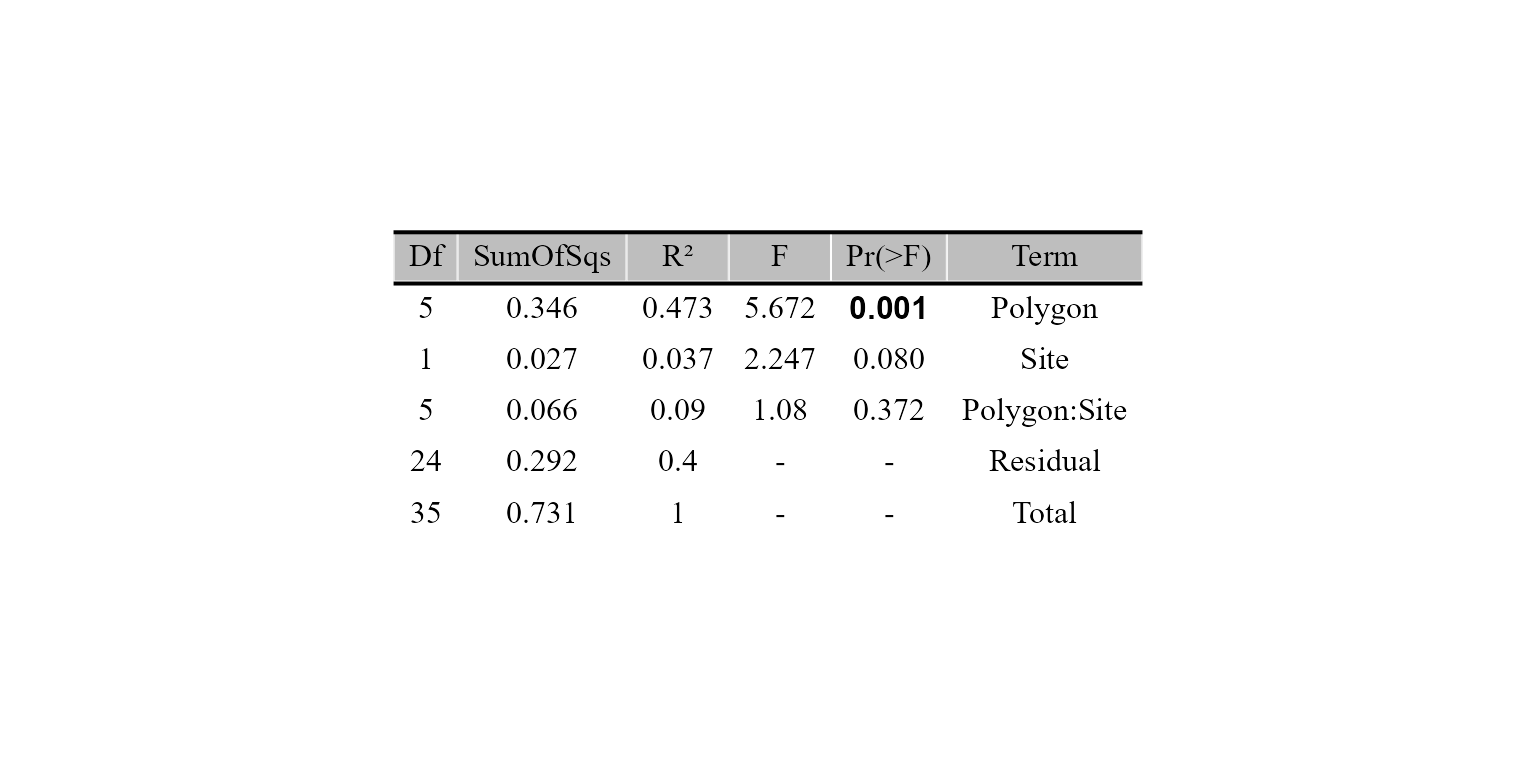
Pruebas estadísticas para diversidad beta
distance = "bray" coincide con el usado en la ordenación
de arriba, de modo que la ordenación (vía el paquete vegan
(Oksanen et al. 2024)) y la prueba
PERMANOVA (Anderson 2001) evalúan la
misma noción de disimilitud.
El resultado es una figura de la tabla (un ggplot), así que se puede
combinar con otros gráficos (p. ej. cowplot::plot_grid()) o
guardar con ggplot2::ggsave(). Usa
save_table = TRUE para obtener también los resultados en un
archivo de texto.
beta_test_table(
    table = table_meta,
    metadata = metadata_meta,
    formula_str = "Polygon*Site",
    distance = "bray",
    test = "permanova",
    permutations = 999
)
Decaimiento de la similitud comunitaria con la distancia
beta_decay_plot() evalúa si las comunidades
geográficamente más cercanas también son más similares en composición,
mediante una prueba de Mantel (Mantel 1967):
beta_decay_plot(
    table    = table_meta,
    metadata = metadata_meta,
    lat_col  = "Latitude",
    lon_col  = "Longitude",
    distance = "bray"
)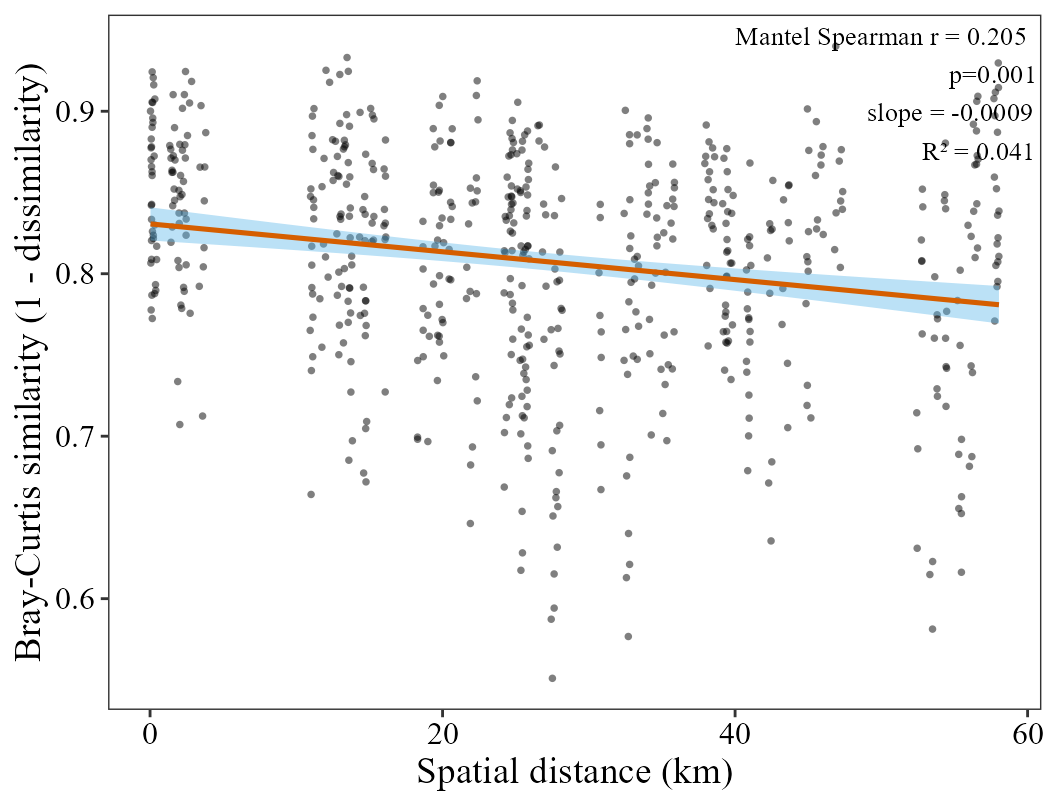
Las comunidades geográficamente más cercanas son significativamente
más similares en composición (Mantel r ≈ 0.21, p ≈
0.001; el valor p exacto varía ligeramente entre corridas ya que la
prueba de Mantel se basa en permutaciones), una señal real de
decaimiento con la distancia en estos suelos forestales. Sin embargo, la
relación es débil: la distancia explica solo cerca del 4 % de la
variación en la similitud (R² ≈ 0.04). Se usa bray para ser
consistentes con la ordenación de arriba.
Análisis de abundancia diferencial
Para las versiones de heatmap (ALDEx2 (Fernandes et al. 2014)) y
ANCOM-BC2 (Lin and
Peddada 2024) necesitamos un subconjunto de 2 grupos del
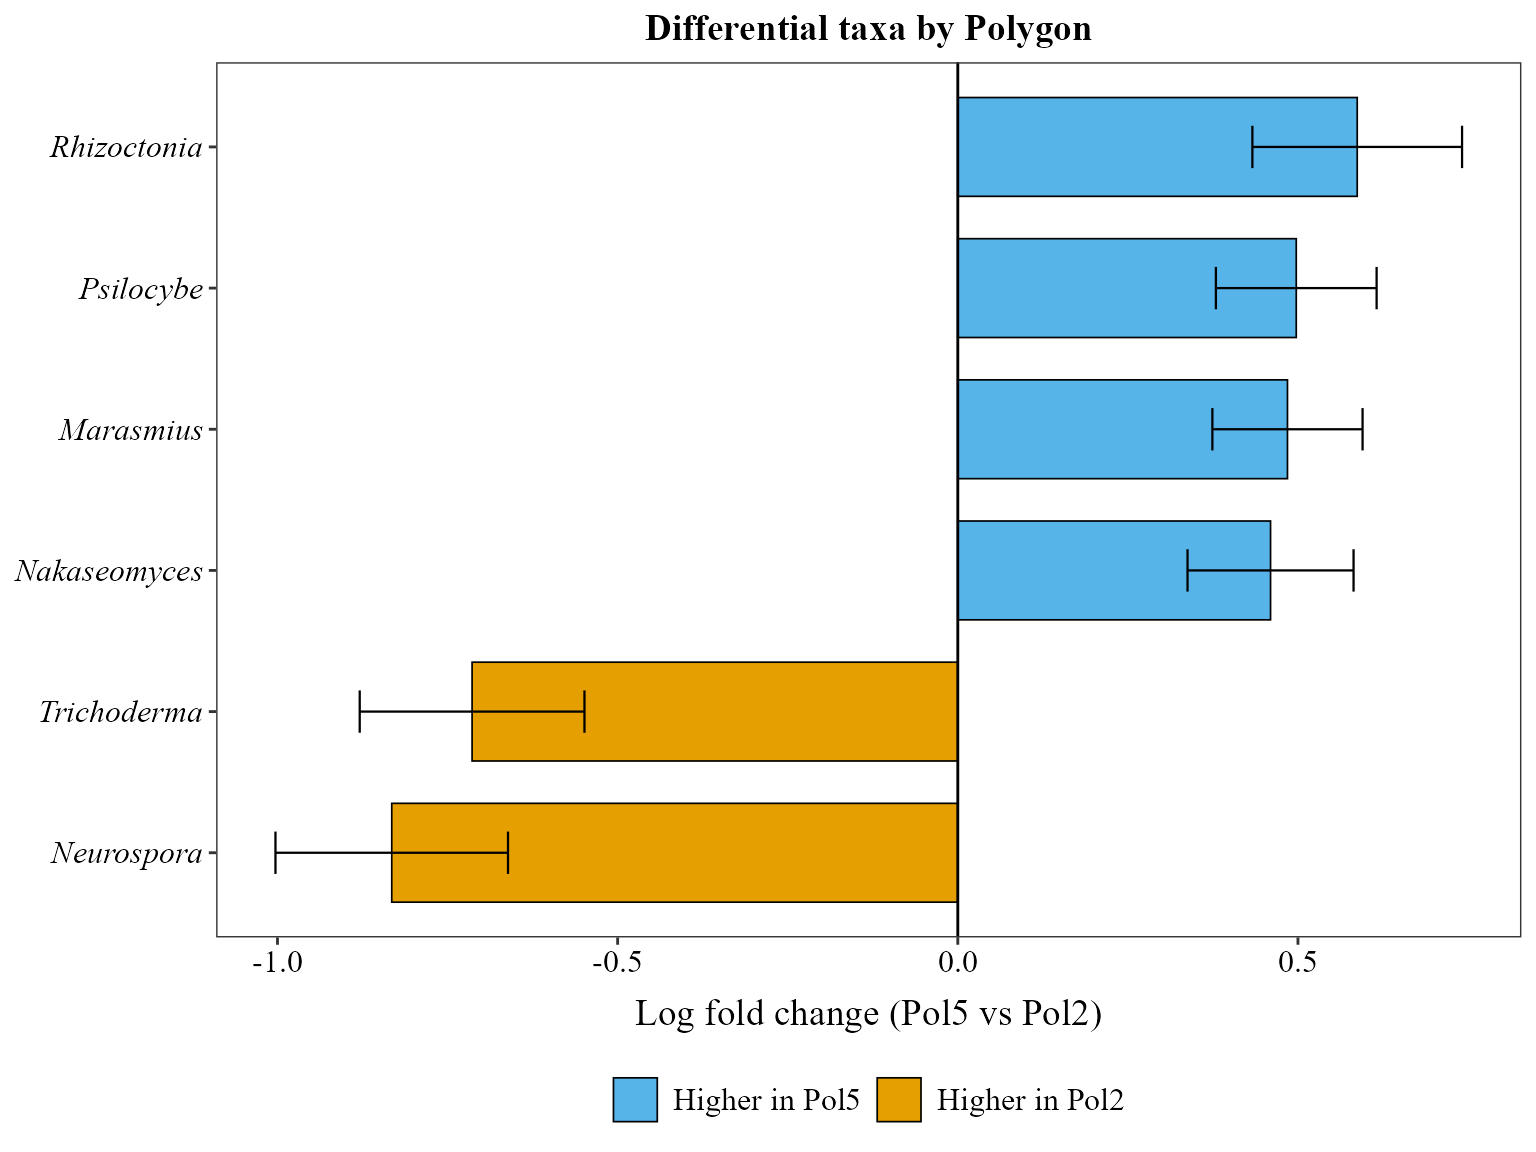
Polygon de 6 niveles; en esta parte compararemos Polygon 2
y 5:
metadata_meta_compar <- metadata_meta %>%
    filter(Polygon == "Pol2" | Polygon == "Pol5")

table_meta_compar <- table_meta[, c(match(metadata_meta_compar$SAMPLEID, colnames(table_meta)), ncol(table_meta))]
aldex_heatmap_plot(
    table = table_meta_compar,
    metadata = metadata_meta_compar,
    group_col = "Polygon"
)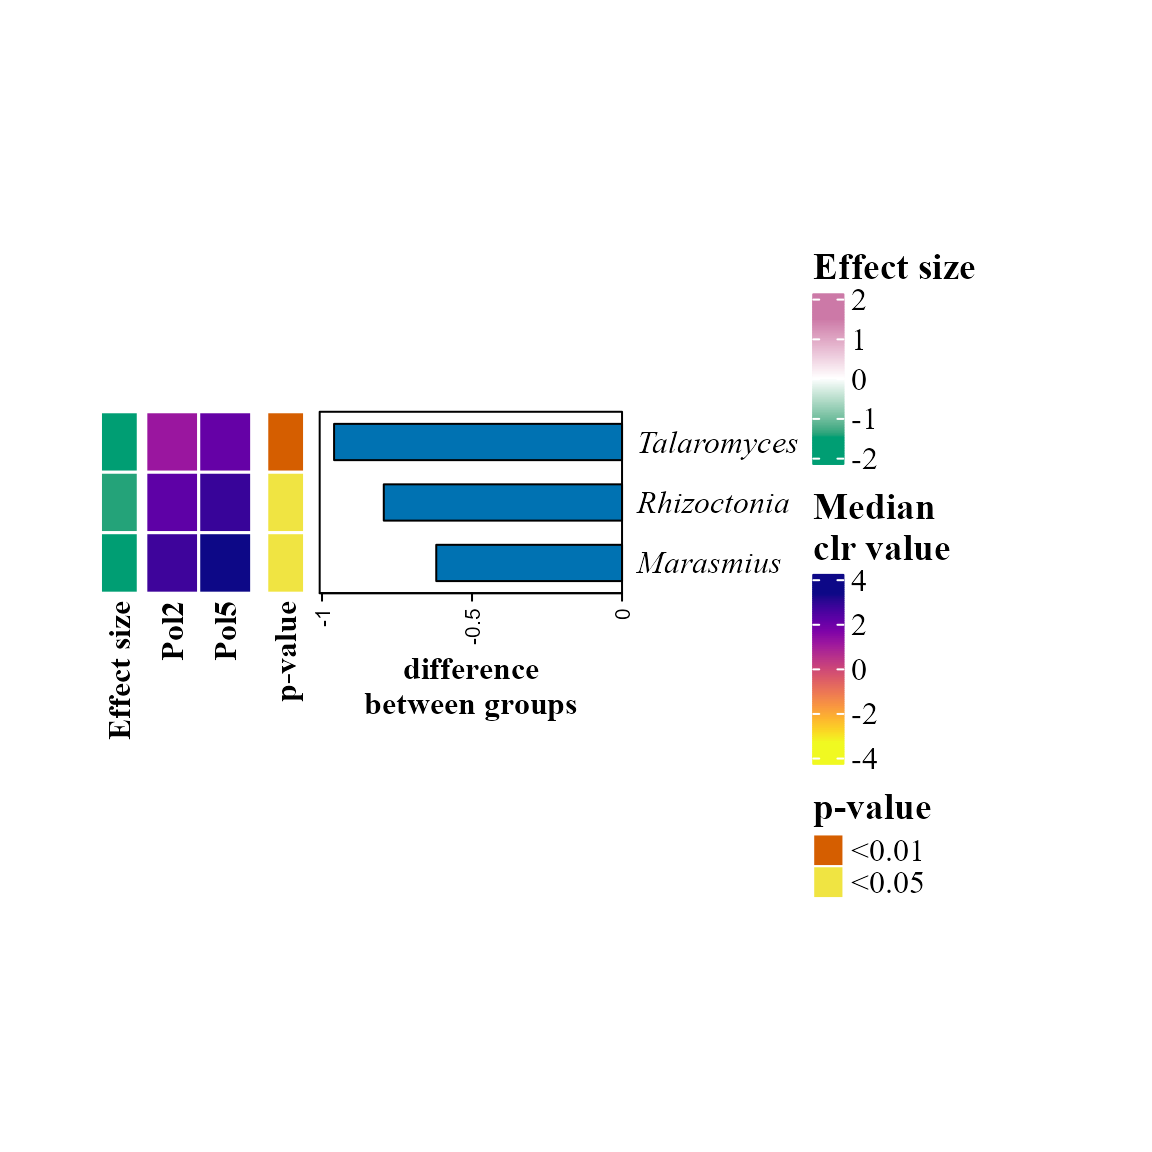
ancombc_plot(
    table = table_meta_compar,
    metadata = metadata_meta_compar,
    group_col = "Polygon",
    level = "Genus",
    min_prevalence = 0.05,
    p_adjust_method = "BH"
)
Identificando taxones importantes
random_forest_lollipop_plot() usa un modelo Random
Forest (Breiman 2001) para
encontrar los taxones que mejor predicen el polígono:
random_forest_lollipop_plot(table = table_meta, metadata = metadata_meta, top_n = 10, variable_to_predict = "Polygon")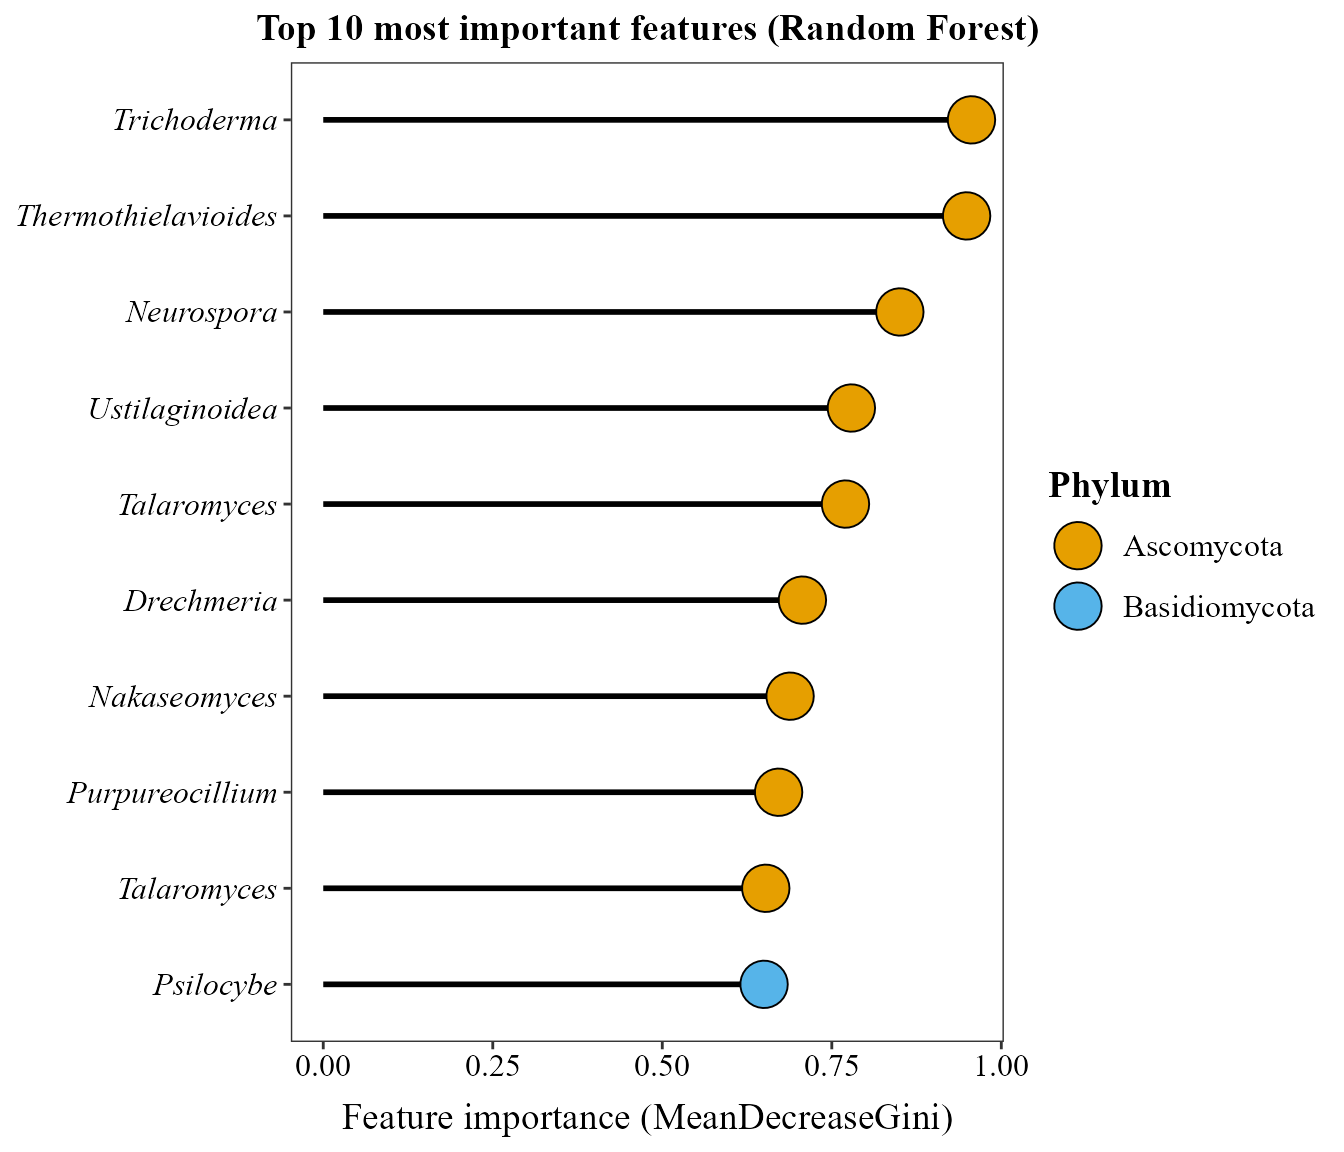
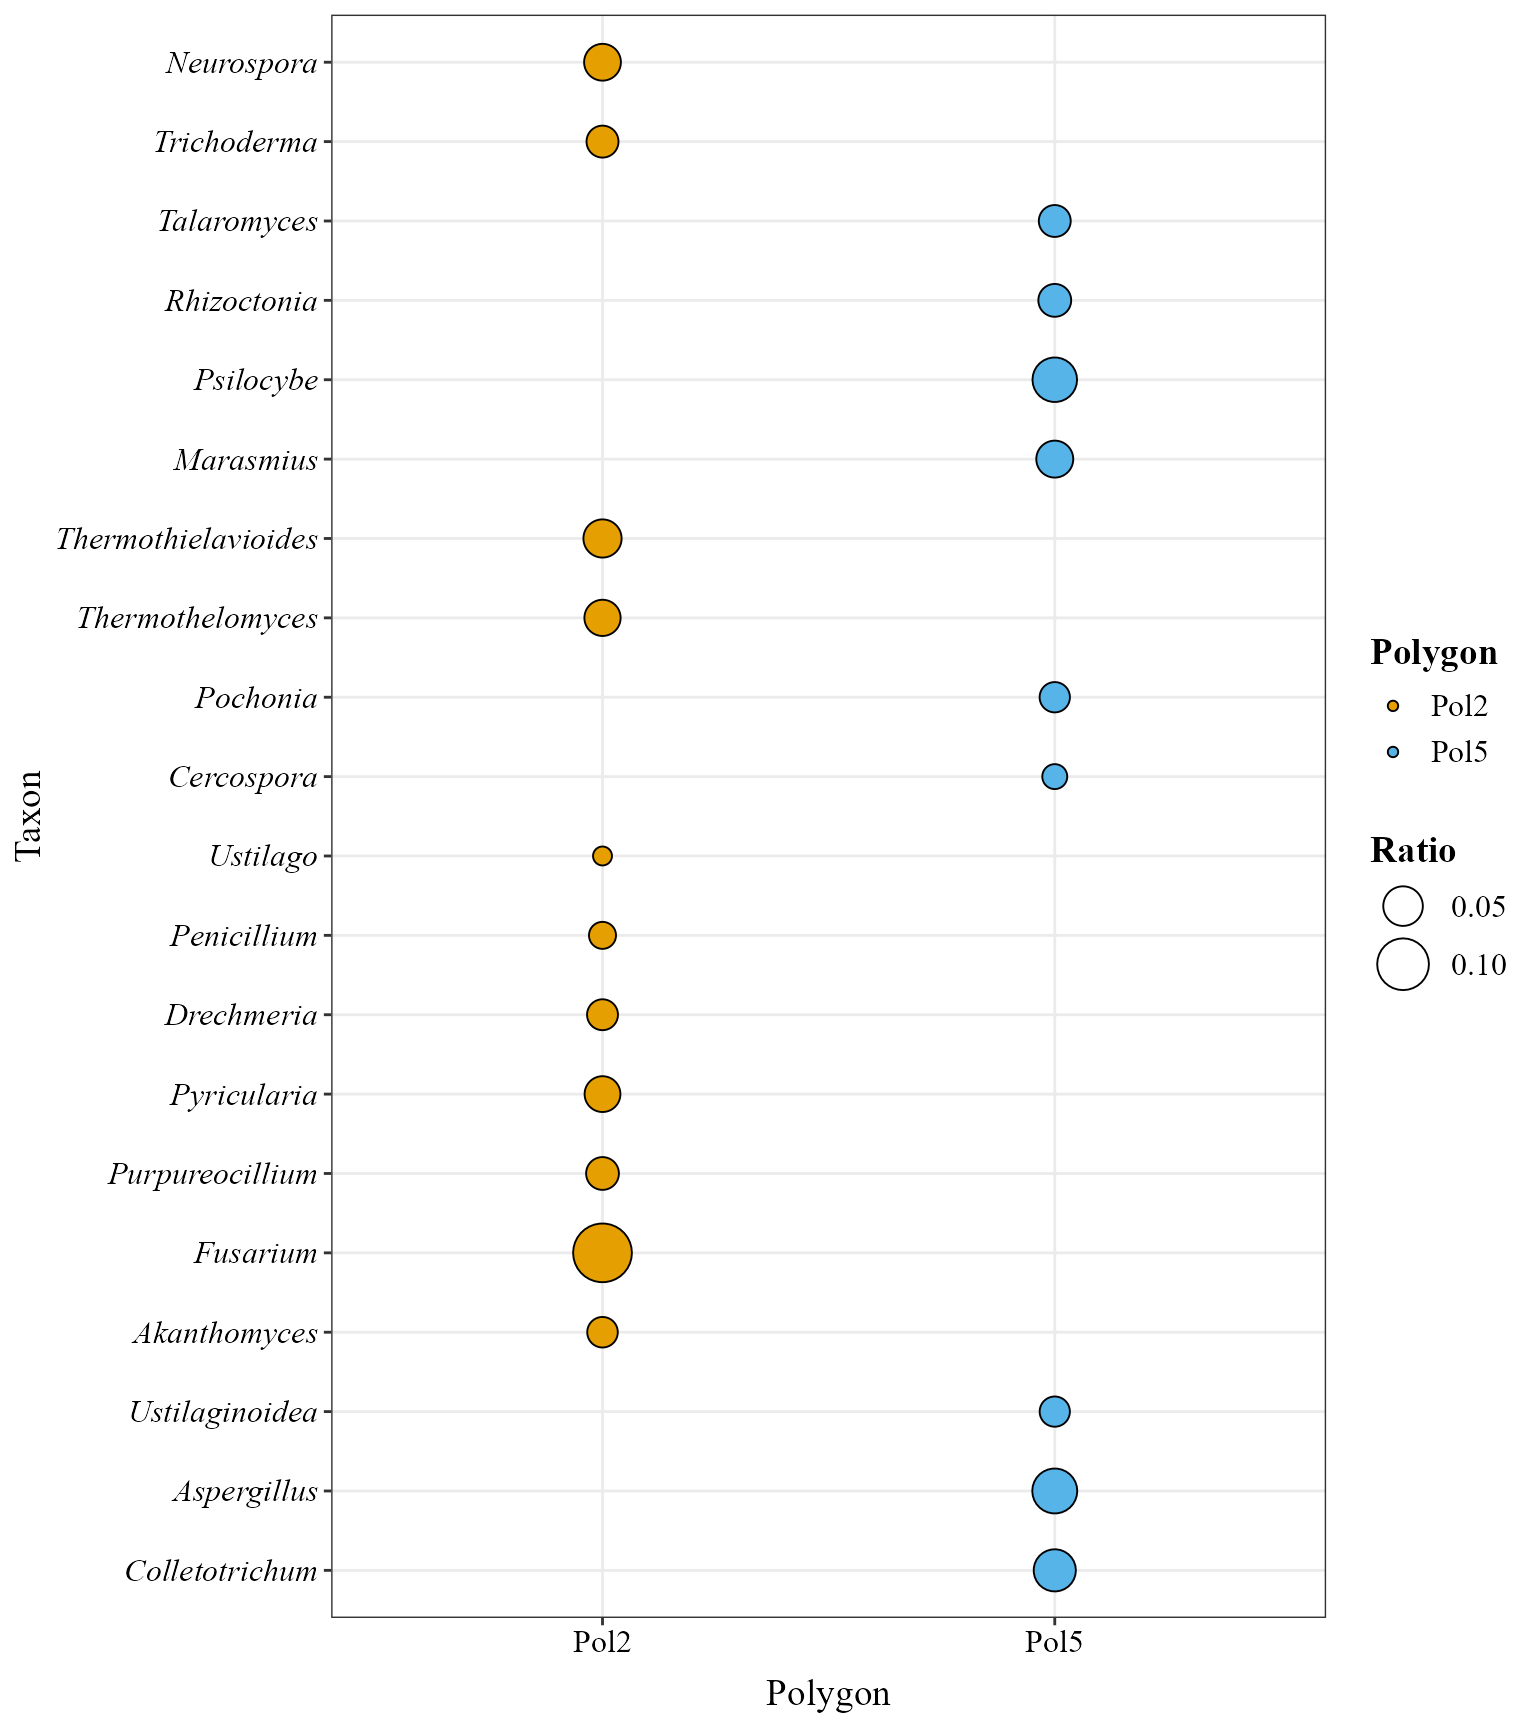
ratios_bubble_plot(
    table = table_meta_compar,
    metadata = metadata_meta_compar,
    group_col = "Polygon",
    top_n = 20,
    condition_A = "Pol2",
    condition_B = "Pol5"
)
Análisis ambientales
Los metadatos ya traen las variables fisicoquímicas del suelo medidas
para estas muestras, así que, como en la viñeta de amplicón, las
variables se eligen por nombre con env_vars (no hace falta
una tabla ambiental aparte):
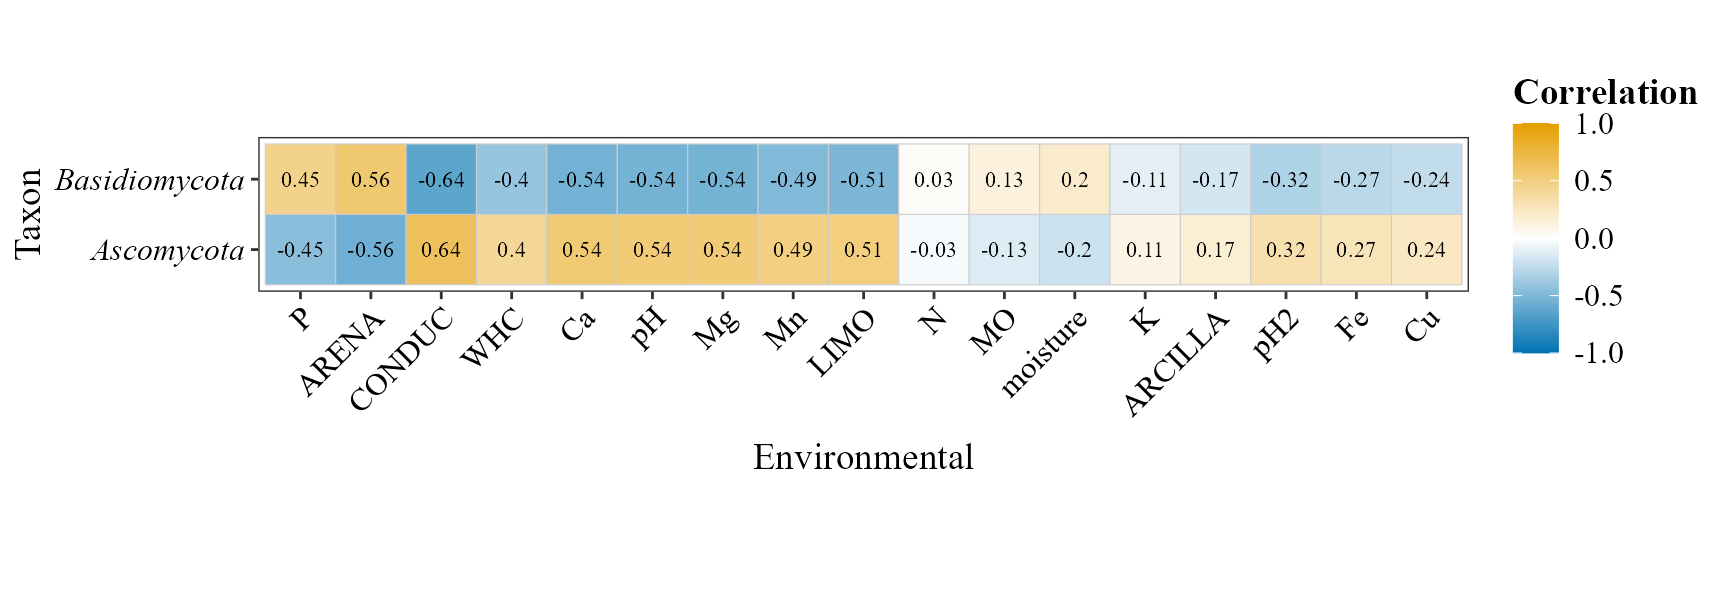
Correlación entre variables ambientales y abundancia taxonómica
corr_env_abund_plot(
    table = table_meta,
    metadata = metadata_meta,
    env_vars = env_vars_meta,
    taxonomy_db = "Kraken2",
    level = "phylum",
    save_table = FALSE
)
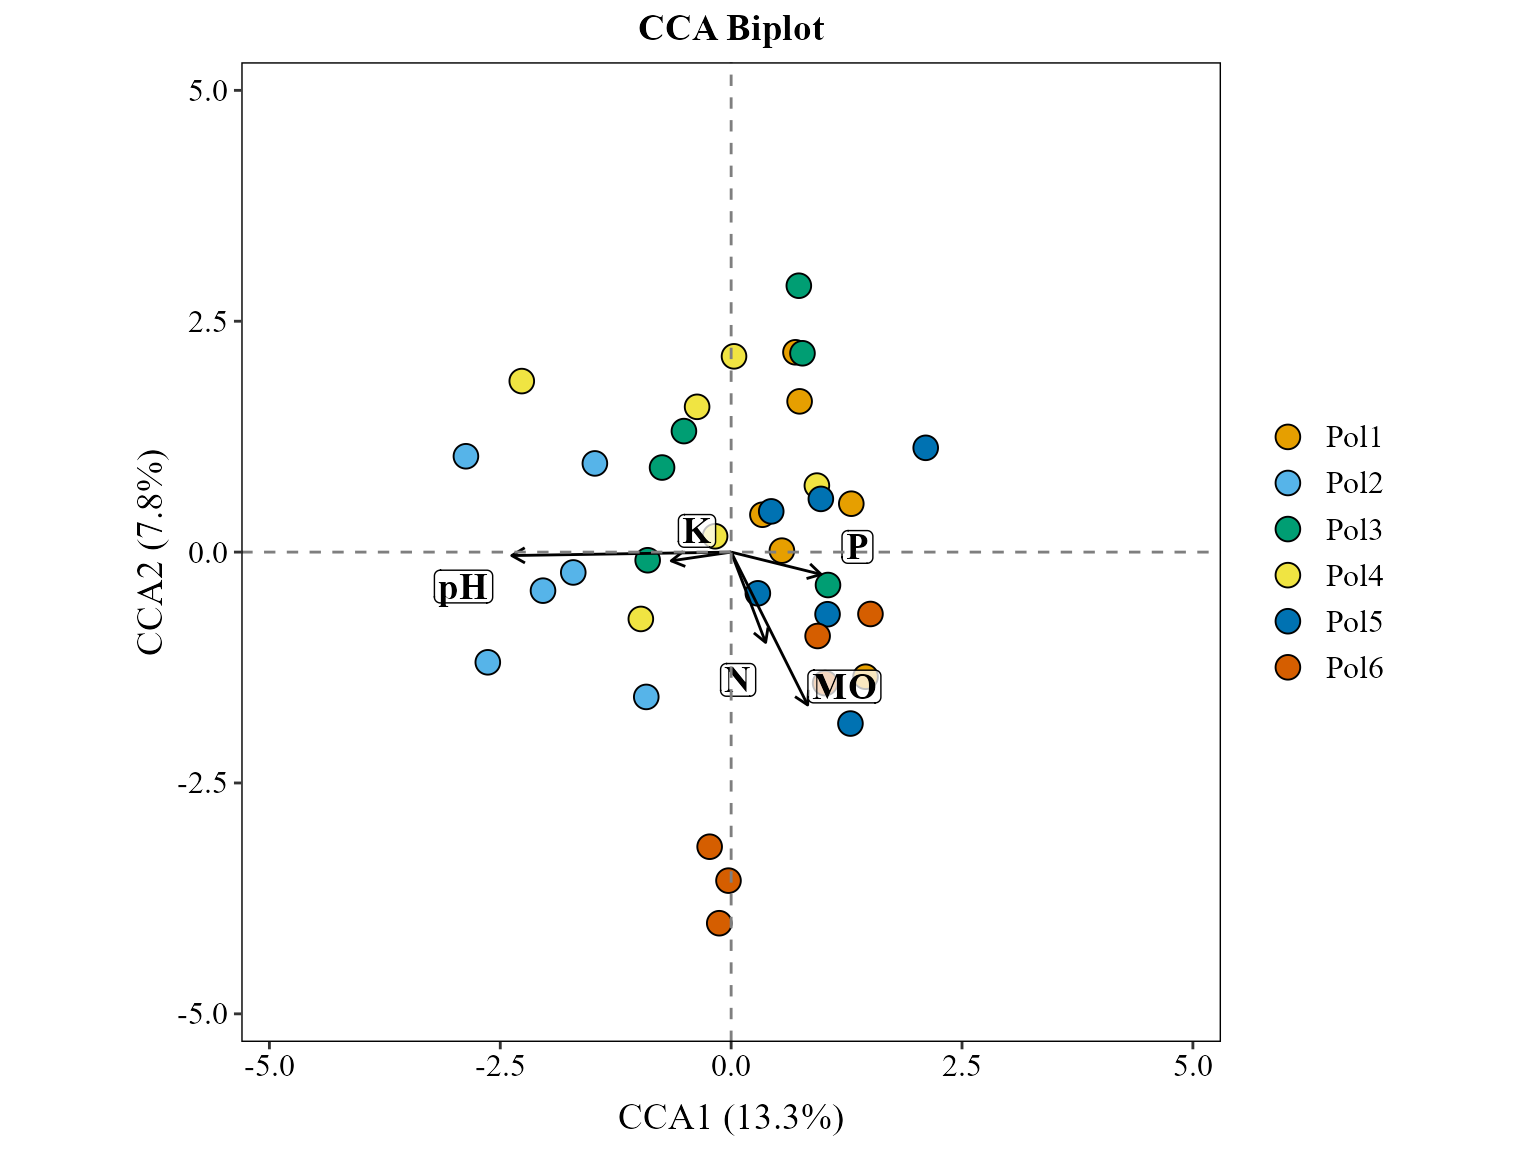
Ordenación restringida (CCA)
cca_rda_biplot(
    table = table_meta,
    metadata = metadata_meta,
    env_vars = c("pH", "MO", "N", "P", "K"),
    analysis = "CCA",
    show_all_env_vectors = TRUE,
    group_col = "Polygon",
    scale_arrows = 3
)
Referencias
Información de la sesión
## R version 4.6.1 (2026-06-24 ucrt)
## Platform: x86_64-w64-mingw32/x64
## Running under: Windows 10 x64 (build 19045)
##
## Matrix products: default
##   LAPACK version 3.12.1
##
## locale:
## [1] LC_COLLATE=Spanish_Latin America.utf8
## [2] LC_CTYPE=Spanish_Latin America.utf8
## [3] LC_MONETARY=Spanish_Latin America.utf8
## [4] LC_NUMERIC=C
## [5] LC_TIME=Spanish_Latin America.utf8
##
## time zone: America/Mexico_City
## tzcode source: internal
##
## attached base packages:
## [1] stats     graphics  grDevices utils     datasets  methods   base
##
## other attached packages:
##  [1] doRNG_1.8.6.3       rngtools_1.5.2      foreach_1.5.2
##  [4] lubridate_1.9.5     forcats_1.0.1       stringr_1.6.0
##  [7] dplyr_1.2.1         purrr_1.2.2         readr_2.2.0
## [10] tidyr_1.3.2         tibble_3.3.1        ggplot2_4.0.3
## [13] tidyverse_2.0.0     MicroBioMeta_0.99.0
##
## loaded via a namespace (and not attached):
##   [1] splines_4.6.1                   cellranger_1.1.0
##   [3] rpart_4.1.27                    lifecycle_1.0.5
##   [5] Rdpack_2.6.6                    rstatix_1.1.0
##   [7] doParallel_1.0.17               lattice_0.22-9
##   [9] MASS_7.3-65                     backports_1.5.1
##  [11] hillR_0.5.2                     magrittr_2.0.5
##  [13] Hmisc_5.3-0                     sass_0.4.10
##  [15] rmarkdown_2.32                  jquerylib_0.1.4
##  [17] yaml_2.3.12                     otel_0.2.0
##  [19] ggvenn_0.1.19                   gld_2.6.8
##  [21] minqa_1.2.8                     cowplot_1.2.0
##  [23] RColorBrewer_1.1-3              multcomp_1.4-32
##  [25] abind_1.4-8                     quadprog_1.5-8
##  [27] expm_1.0-1                      GenomicRanges_1.64.0
##  [29] BiocGenerics_0.58.1             TH.data_1.1-5
##  [31] yulab.utils_0.2.5               nnet_7.3-20
##  [33] sandwich_3.1-3                  rappdirs_0.3.4
##  [35] circlize_0.4.18                 IRanges_2.46.0
##  [37] S4Vectors_0.50.3                ggrepel_0.9.8
##  [39] tidytree_0.4.8                  vegan_2.7-6
##  [41] pkgdown_2.2.1                   permute_0.9-10
##  [43] codetools_0.2-20                DelayedArray_0.38.2
##  [45] energy_1.7-12                   tidyselect_1.2.1
##  [47] shape_1.4.6.1                   farver_2.1.2
##  [49] lme4_2.0-6                      matrixStats_1.5.0
##  [51] stats4_4.6.1                    base64enc_0.1-6
##  [53] Seqinfo_1.2.0                   ALDEx2_1.44.0
##  [55] jsonlite_2.0.0                  GetoptLong_1.1.1
##  [57] multtest_2.68.0                 e1071_1.7-17
##  [59] Formula_1.2-6                   survival_3.8-6
##  [61] iterators_1.0.14                systemfonts_1.3.2
##  [63] tools_4.6.1                     treeio_1.36.1
##  [65] ragg_1.5.2                      DescTools_0.99.60
##  [67] Rcpp_1.1.2                      ggVennDiagram_1.5.7
##  [69] glue_1.8.1                      gridExtra_2.3.1
##  [71] SparseArray_1.12.2              xfun_0.61
##  [73] mgcv_1.9-4                      MatrixGenerics_1.24.0
##  [75] TreeSummarizedExperiment_2.20.0 numDeriv_2016.8-1.1
##  [77] withr_3.0.3                     fastmap_1.2.0
##  [79] ggh4x_0.3.1                     latticeExtra_0.6-31
##  [81] boot_1.3-32                     digest_0.6.39
##  [83] truncnorm_1.0-9                 timechange_0.4.0
##  [85] R6_2.6.1                        textshaping_1.0.5
##  [87] colorspace_2.1-3                Cairo_1.7-0
##  [89] gtools_3.9.5                    jpeg_0.1-11
##  [91] dichromat_2.0-1                 generics_0.1.4
##  [93] data.table_1.18.6.1             class_7.3-23
##  [95] httr_1.4.9                      htmlwidgets_1.6.4
##  [97] S4Arrays_1.12.0                 pkgconfig_2.0.3
##  [99] gtable_0.3.6                    Exact_3.3
## [101] zCompositions_1.6.2             ComplexHeatmap_2.28.0
## [103] S7_0.2.2                        SingleCellExperiment_1.34.0
## [105] XVector_0.52.0                  htmltools_0.5.9
## [107] carData_3.0-6                   zigg_0.0.2
## [109] clue_0.3-68                     scales_1.4.0
## [111] Biobase_2.72.0                  lmom_3.3
## [113] png_0.1-9                       reformulas_0.4.4
## [115] ANCOMBC_2.14.0                  knitr_1.52
## [117] rstudioapi_0.19.0               geosphere_1.6-8
## [119] tzdb_0.5.0                      rjson_0.2.23
## [121] nloptr_2.2.1                    checkmate_2.3.4
## [123] nlme_3.1-169                    zoo_1.9-1
## [125] proxy_0.4-29                    cachem_1.1.0
## [127] GlobalOptions_0.1.4             rootSolve_1.8.2.4
## [129] parallel_4.6.1                  foreign_0.8-91
## [131] desc_1.4.3                      pillar_1.11.1
## [133] grid_4.6.1                      vctrs_0.7.3
## [135] randomForest_4.7-1.2            ggpubr_1.0.0
## [137] car_3.1-5                       cluster_2.1.8.2
## [139] htmlTable_2.5.0                 evaluate_1.0.5
## [141] magick_2.9.1                    mvtnorm_1.4-2
## [143] cli_3.6.6                       compiler_4.6.1
## [145] rlang_1.3.0                     crayon_1.5.3
## [147] ggsignif_0.6.4                  labeling_0.4.3
## [149] interp_1.1-6                    fs_2.1.0
## [151] stringi_1.8.9                   viridisLite_0.4.3
## [153] deldir_2.0-4                    BiocParallel_1.46.0
## [155] lmerTest_3.2-1                  gsl_2.1-9
## [157] Biostrings_2.80.2               lazyeval_0.2.3
## [159] Matrix_1.7-5                    hms_1.1.4
## [161] patchwork_1.3.2                 NADA_1.6-1.2
## [163] SummarizedExperiment_1.42.0     haven_2.5.5
## [165] rbibutils_2.4.1                 Rfast_2.1.5.2
## [167] broom_1.0.13                    RcppParallel_6.2.1
## [169] bslib_0.12.0                    directlabels_2026.8.27
## [171] readxl_1.5.0.1                  ape_5.8-1